불러오는 중
언급량 비교
두 주제어(선택 시 세 주제어까지)를 같은 기간·같은 채널로 나란히 놓고, 언급량 추이·구성비·점유율을 한 화면에서 견주는 비교 기능입니다. 각 키워드가 얼마나 화제가 됐는지를 총량뿐 아니라 '대화의 몇 %를 가져갔는가(SOV)'로 읽습니다.
이 기능으로 알 수 있는 것
- 누가 더 화제인가?
- 언급량 점유율(SOV)은 누가 더 높은가?
- 화제의 우열이 최근으로 올수록 벌어지는가, 좁혀지는가?
- 각 키워드의 언급은 어느 채널에서 주로 나오는가?
언제 쓰나요?
경쟁사와 화제성을 견줄 때
→ 총 언급량과 점유율로 누가 대화를 더 점유했는지, 그 격차가 커지는지 줄어드는지를 한눈에 봅니다.
우리 브랜드가 시장에서 차지하는 목소리 크기를 가늠할 때
→ 언급량 점유율 추이로 최근 며칠간 우리 몫이 오르는 추세인지 내려가는 추세인지를 읽습니다.
같은 캠페인 기간 두 제품의 반응 크기를 대조할 때
→ 피크 일자와 채널 구성비 차이로 어느 쪽이 더 넓게 퍼졌는지 확인합니다.
비교 분석이 특별한 이유: 혼자 보면 안 보이는 '상대적 위치'를 읽는다
단일 언급량 분석은 '우리가 얼마나 화제인가'(절대 크기)만 답합니다. 하지만 마케팅 판단은 대개 상대적입니다. '경쟁사보다 큰가·작은가', '격차가 벌어지나·좁혀지나', '우리 목소리 몫(SOV·Share of Voice, 언급량 점유율)이 느나·주나'. 비교 분석은 두 주제어(최대 3개)를 같은 기간·같은 채널에 나란히 세워, 혼자 볼 때는 판단 기준이 없던 숫자에 '상대'라는 잣대를 줍니다. 그래서 비교의 모든 차트는 A(보라)와 B(주황)를 한 화면에 겹쳐, 절대 크기(추이·구성비)와 상대 몫(점유율 SOV)을 함께 읽게 합니다.
- A는 보라, B는 주황으로 색이 고정됩니다. 모든 차트에서 이 색으로 누가 누구인지 구분합니다(세 번째 키워드 C를 넣으면 핑크가 더해져, 도넛은 3분할·점유율은 3층 누적이 됩니다).
- 공정한 비교의 전제는 '같은 조건'입니다. 두 키워드에 같은 기간·채널을 적용해야 격차가 조건 탓이 아닌 실제 화제 차이가 됩니다.
화면을 이렇게 읽어냅니다
주제어·동의어·포함어·제외어 입력이 처음이라면 분석 키워드 설정을 먼저 보세요.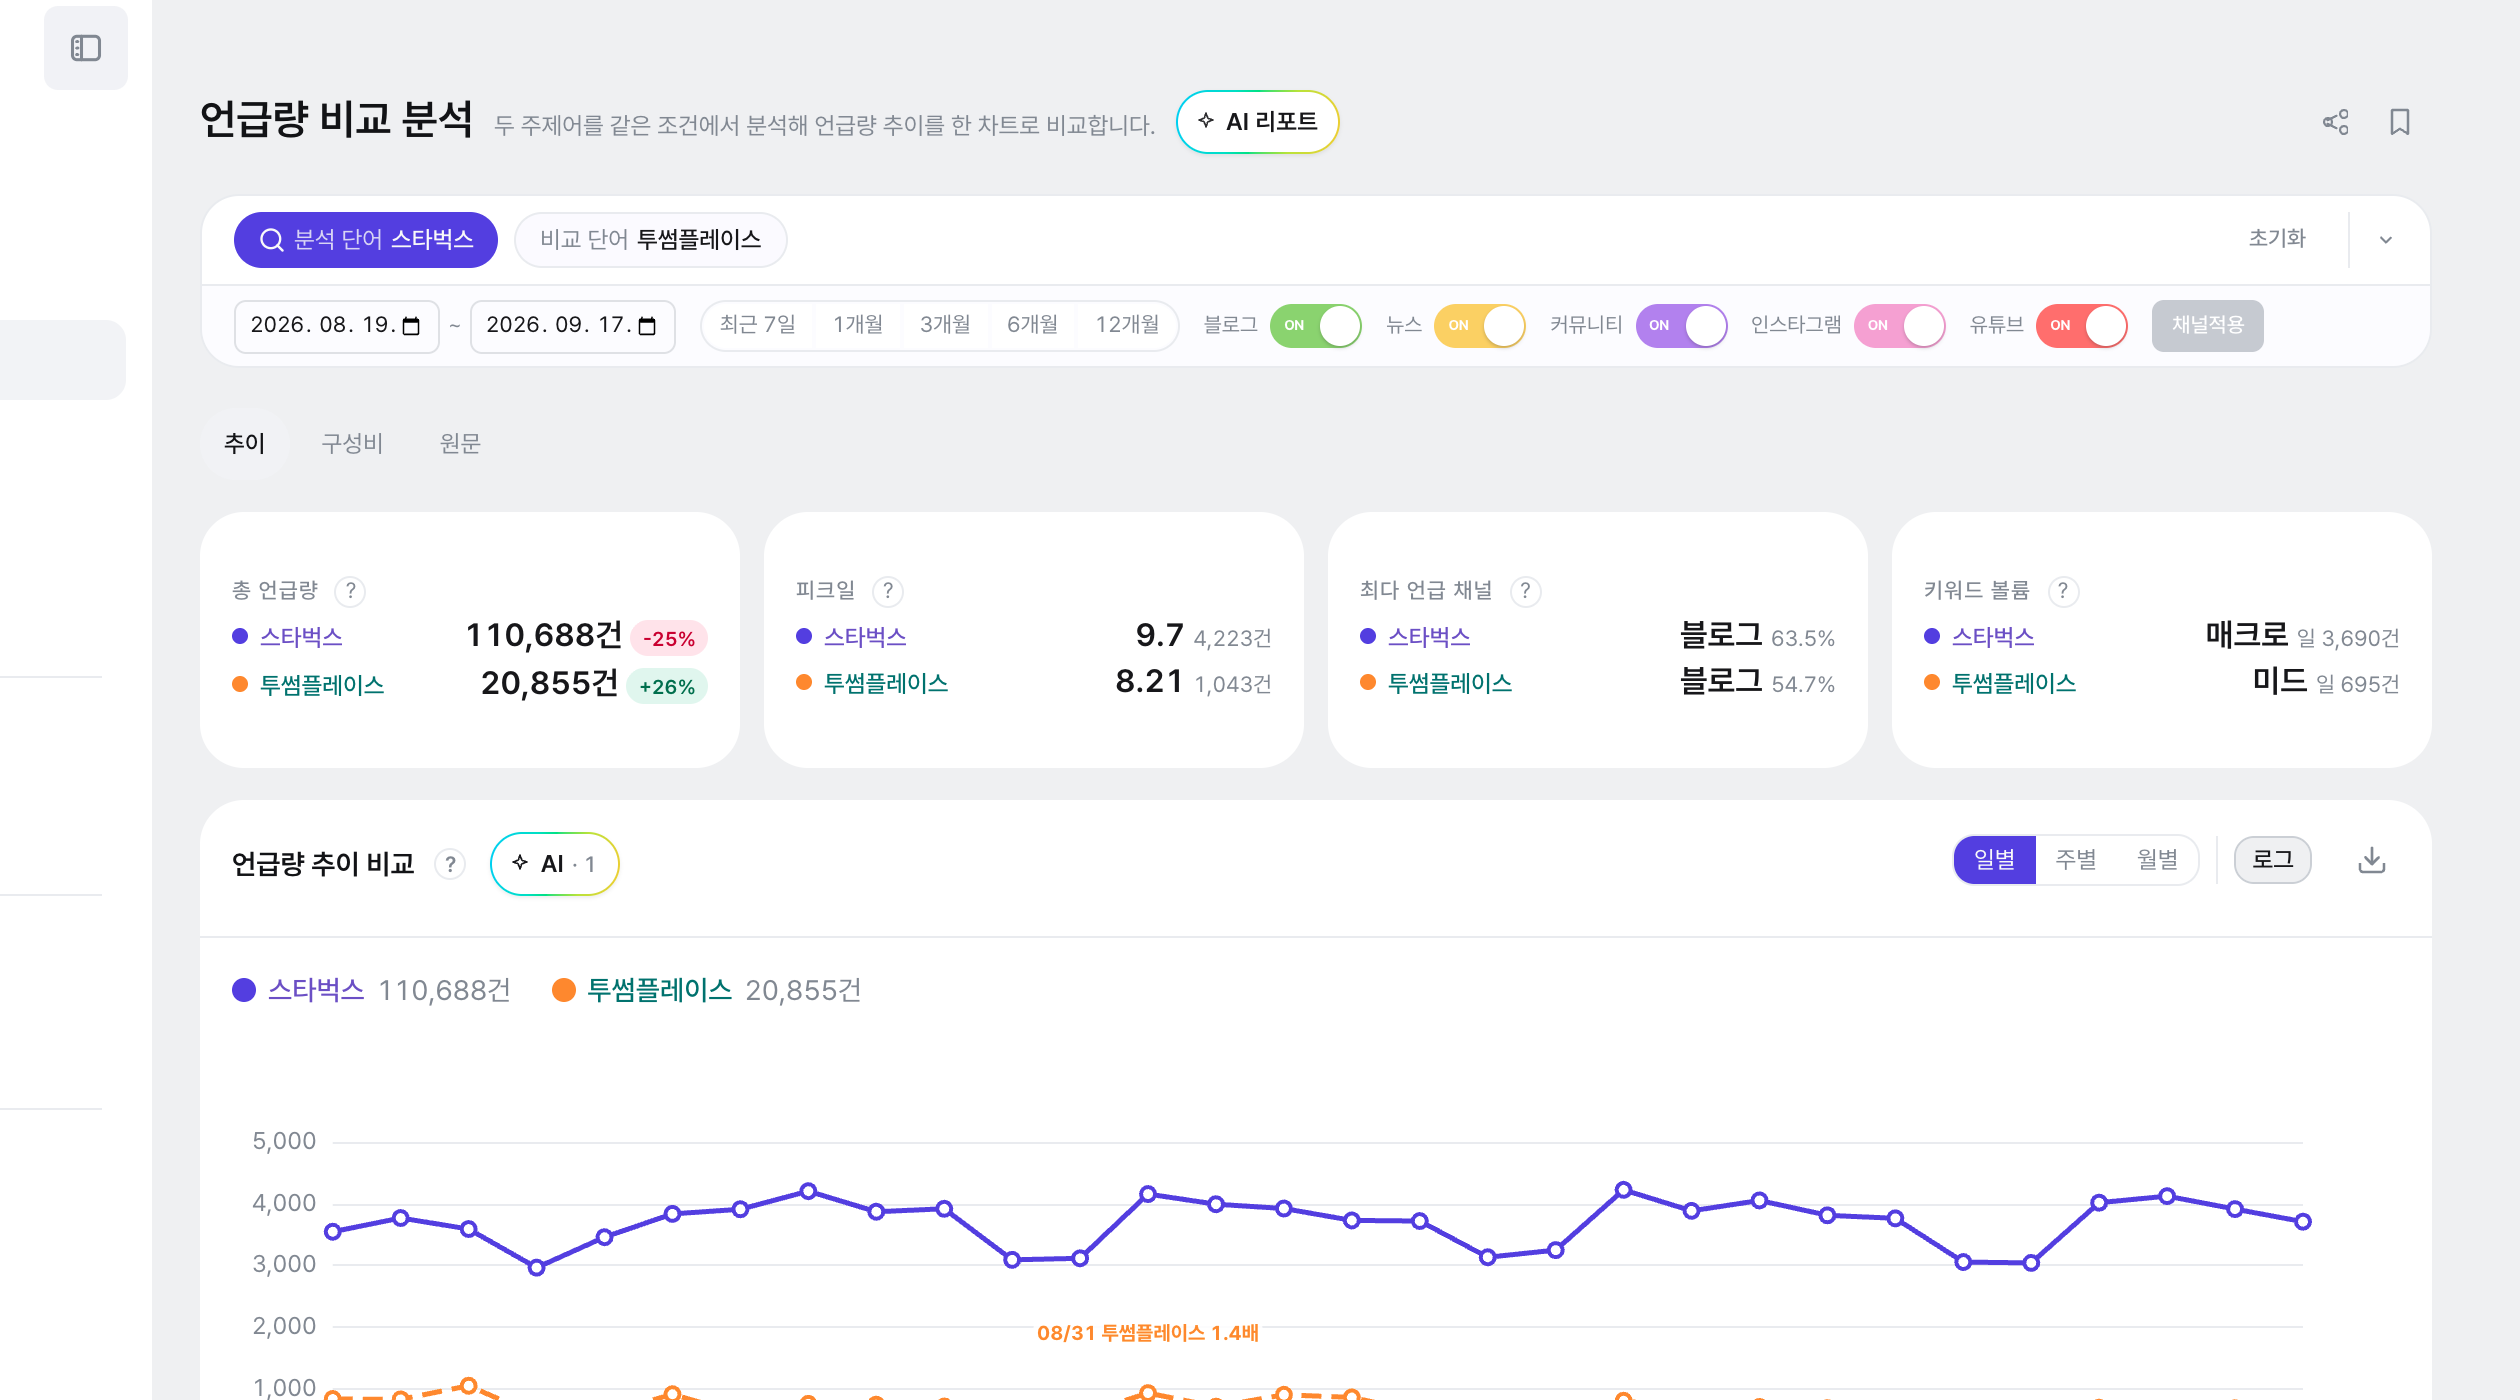
- ① 요약 KPI · 전년 동기 대비핵심
카드 네 장(총 언급량·피크일·최다 언급 채널·키워드 볼륨)에 키워드별로 한 줄씩(보라=A, 주황=B) 값을 보여 줍니다. 총 언급량 줄의 배지는 작년 같은 기간 대비 증감률이며, 전년 데이터를 확인할 수 없는 키워드는 배지가 없습니다. 최다 언급 채널 옆 숫자는 그 키워드 총 언급량 대비 비중이고, 키워드 볼륨 등급은 채널·필터를 바꿔도 달라지지 않는 주제어 전체 규모 기준입니다.
비교의 결론을 문장 없이 숫자로 먼저 발견합니다. 전년 대비 증감률을 나란히 보면 '지금 누가 더 빠르게 커지는가'가 드러납니다. 신라면 +5% vs 진라면 -14%처럼 한쪽은 성장, 한쪽은 후퇴면 시장 무게추가 이동 중이라는 신호입니다.
전년 동기 대비는 작년 같은 기간이 유난히 조용/시끄러웠으면 왜곡됩니다. 한 해의 특수 이슈가 낀 구간은 증감률을 단독 근거로 삼지 않습니다.
- ② 언급량 추이 비교 (절대 크기)핵심
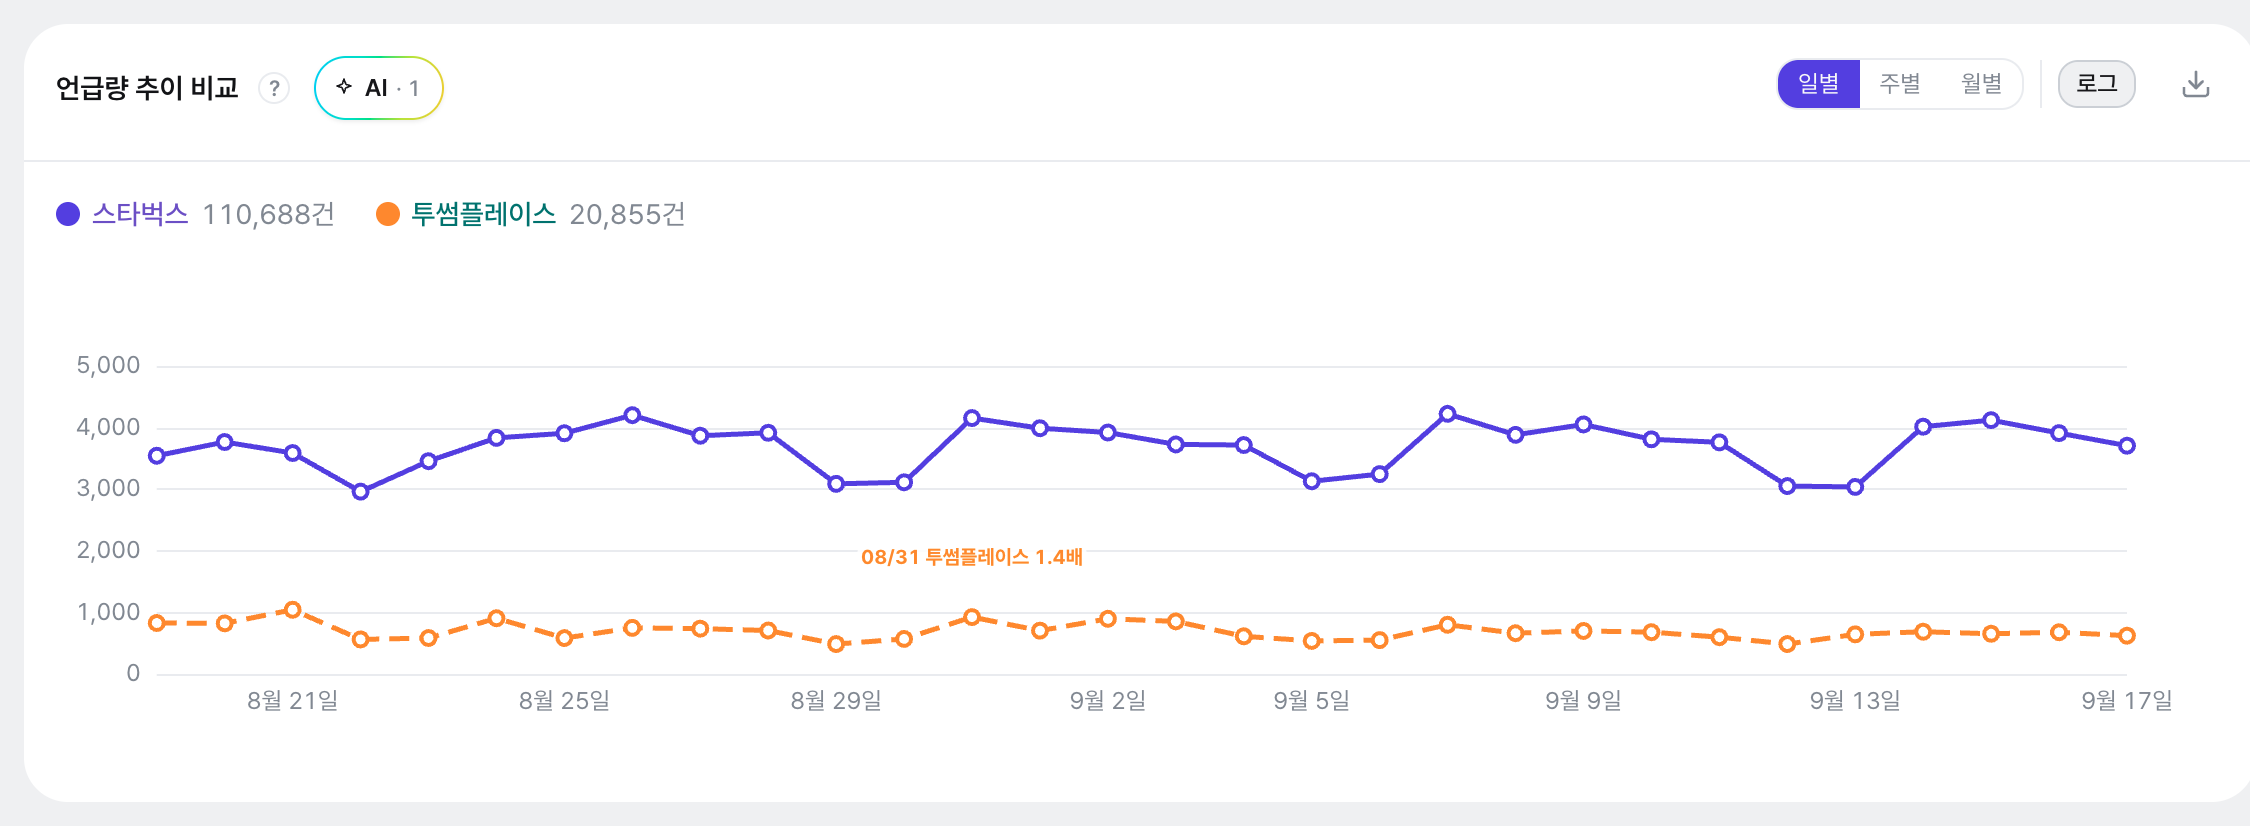
두 키워드의 일별(주별·월별) 언급량을 한 차트에 겹쳐 그립니다(보라=A, 주황=B). 각 키워드의 피크 일자가 함께 표시됩니다.
두 키워드의 화제 타이밍이 같은지 다른지를 발견합니다. 피크가 어긋나면 서로 다른 이슈로 화제가 됐다는 신호이고, 겹치면 같은 사건에 함께 반응했다는 뜻입니다.
절대 언급량은 브랜드의 원래 규모에 크게 좌우됩니다. 규모가 다른 키워드는 '누가 더 화제 상승 중인가'를 추세와 점유율로 봐야 공정합니다.
- ④ 출처별 언급량 구성비 (어디서 도는 대화인가)
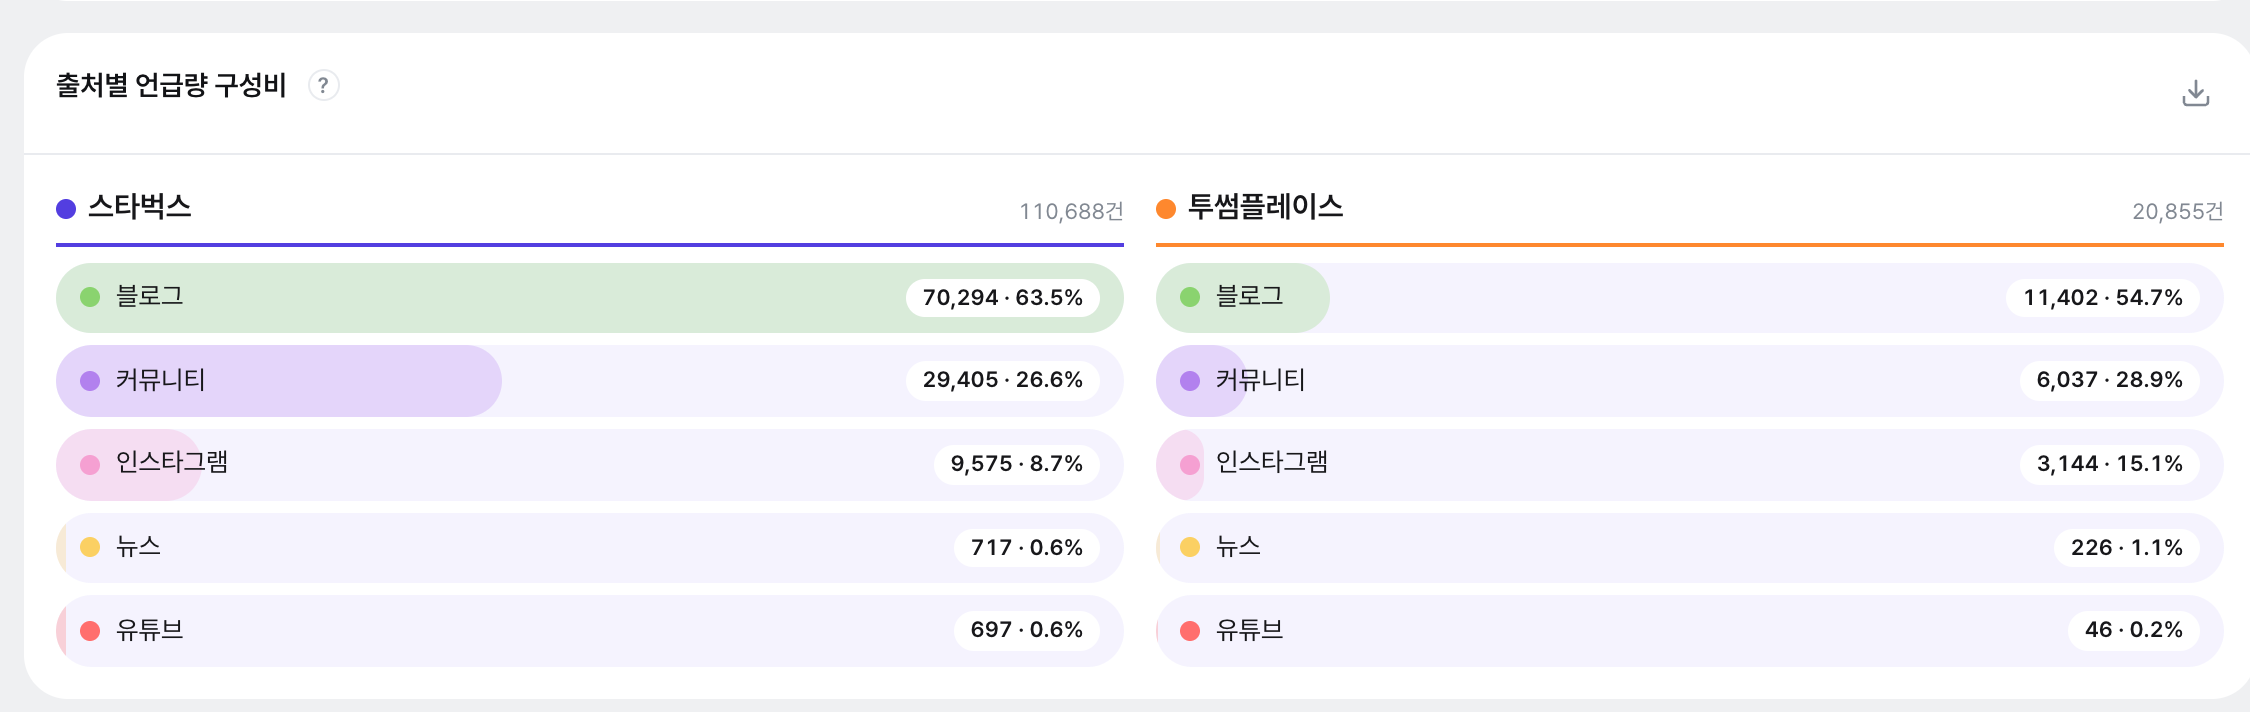
③ 언급량 구성비 카드 아래에 붙는 별도 카드로, 키워드마다 언급을 채널별로 쪼개 출처별 구성비를 나란히 보여 줍니다. 비율의 분모는 그 키워드의 전체 언급량입니다. (예전에 있던 도넛은 구성비 카드의 점유율 선으로 대체됐고, 점유율 추이를 만들 수 없을 때만 도넛이 대신 나옵니다.)
출처별 구성으로 '같은 크기라도 어디서 도는 대화인지'를 봅니다. 한쪽은 커뮤니티 여론, 한쪽은 블로그 후기 중심이라면 대응 채널과 메시지가 달라져야 합니다.
이 비율은 선택한 기간·채널을 합산한 값이라, 기간을 바꾸면 숫자가 통째로 달라집니다. 또 채널별 원래 글 총량 자체가 달라, 블로그 비중이 높다고 곧 '블로그에서 인기'라는 뜻은 아닙니다.
- ③ 언급량 구성비 · 점유율 추이 (SOV · 상대 몫의 흐름)핵심
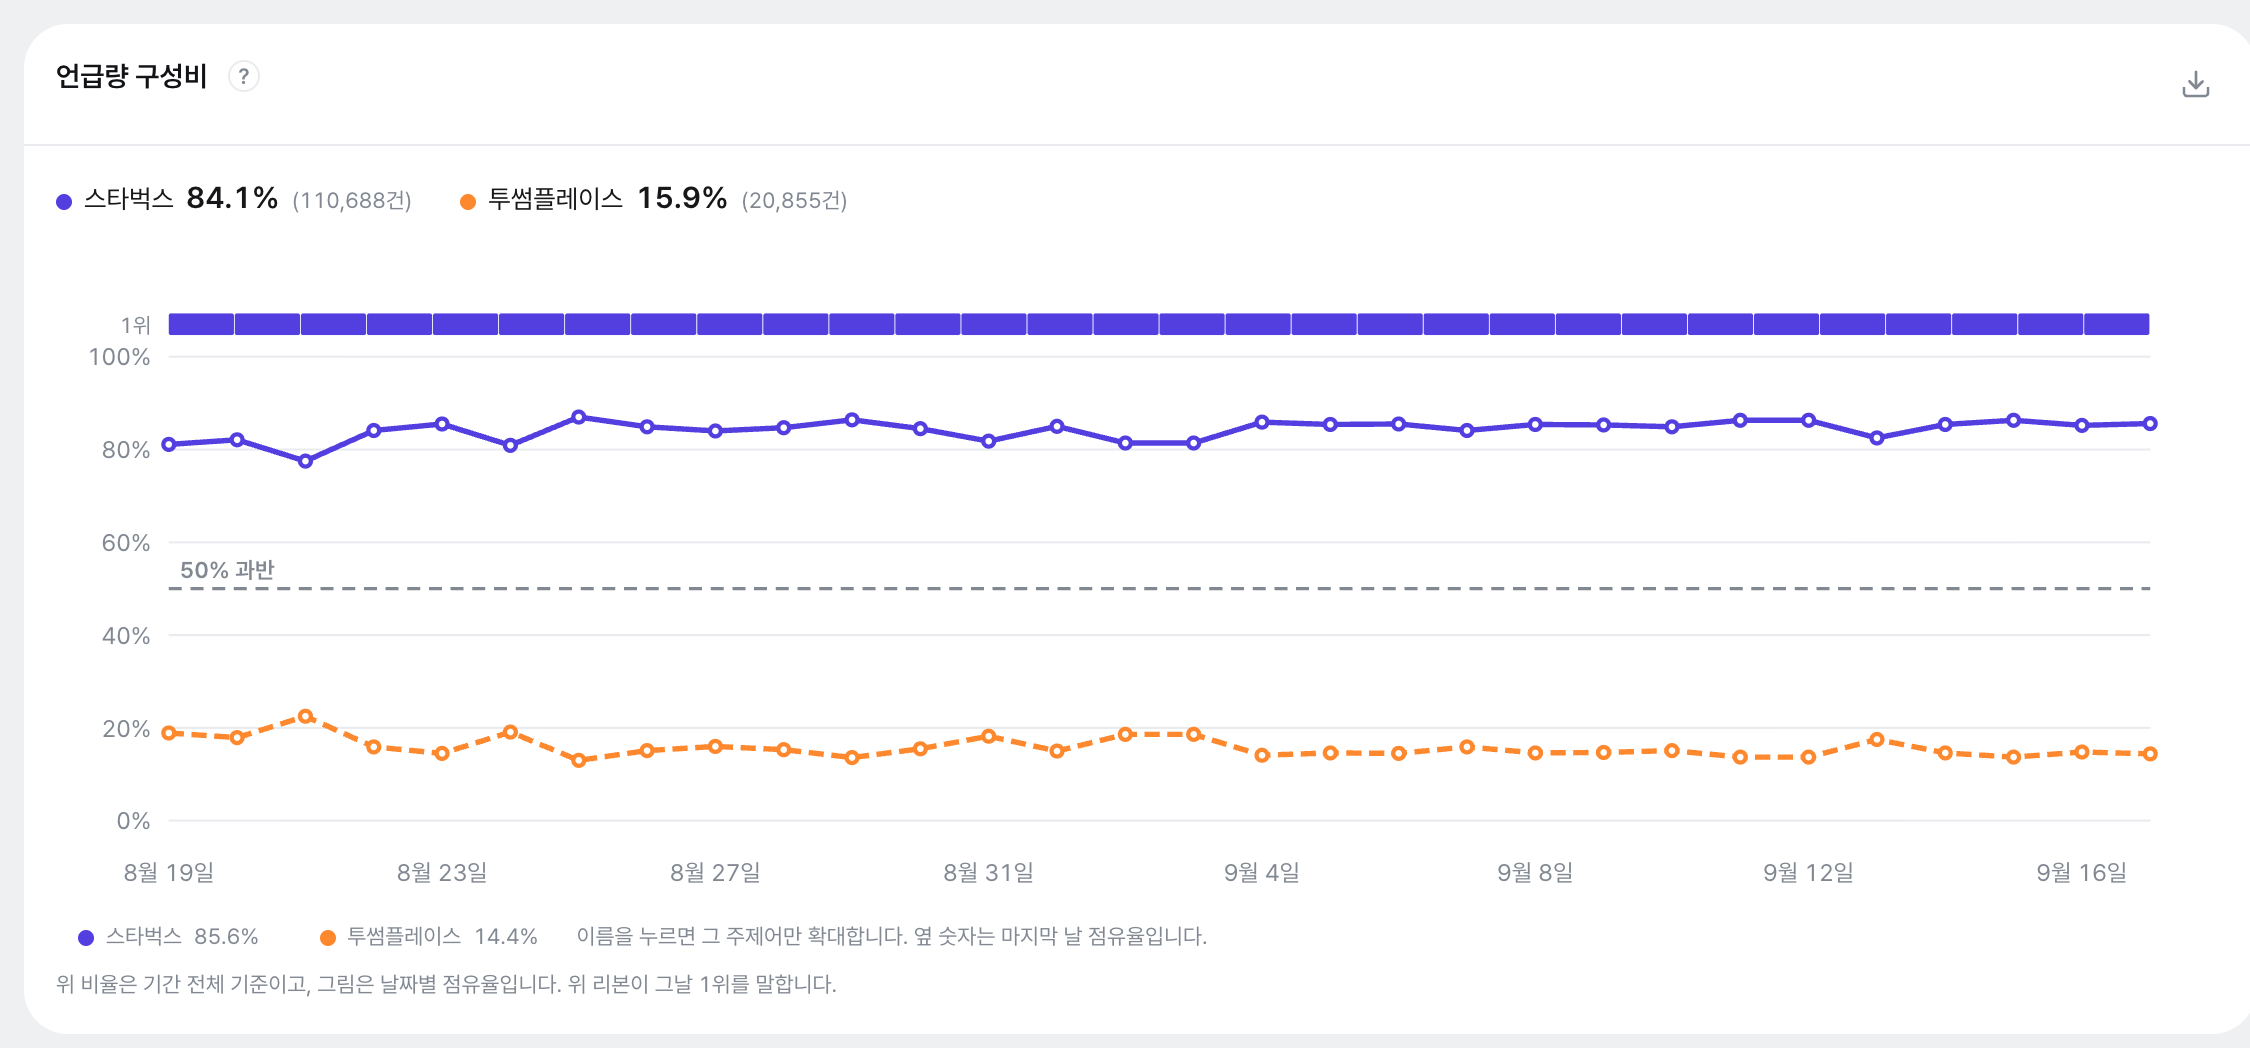
카드 위 범례의 숫자는 기간 전체 기준 각 키워드의 몫(건수 포함)이고, 그 아래 그림은 날짜별 몫(SOV, Share of Voice)을 선으로 겹쳐 그린 것입니다. 선을 쌓지 않고 겹치므로 y축은 데이터 범위에 맞춰 자동으로 좁혀지고, 선이 교차하는 지점이 순위가 뒤바뀐 시점입니다. 차트 위 리본이 날짜별 1위 키워드를 색으로 보여 주고(2개 비교에서 값 범위 안에 들면 50% 점선이 우열의 경계), 범례에서 키워드를 고르면 그 키워드만 남기고 축을 다시 맞춥니다(세 키워드 비교면 분모가 A+B+C 합입니다). ★범례 숫자(기간 전체, 예 81.2%)와 그림의 최신 점(예 76.4%)이 다른 이유는 앞은 기간 전체를 한 덩어리로 본 몫이고, 뒤는 그날의 몫이기 때문입니다.
누가 대화를 더 점유했는지를 발견합니다. 총량 격차만이 아니라 '최근으로 올수록 한쪽 몫이 커지는지'까지 읽혀, 화제성의 방향(추격 중인지 벌어지는 중인지)을 판단할 수 있습니다. 우리 몫이 벌어지는 중이면 콘텐츠 발행 빈도·채널 배분을 유지, 좁혀지는 중이면 재점검하는 식으로 행동에 바로 잇습니다. 이것이 specialSection에서 말한 '상대 잣대'로 위치를 읽는 순간입니다.
점유율은 상대값이라, 두 키워드 모두 언급이 줄어도 한쪽 비율은 오를 수 있습니다(예: A 100→50, B 100→30이면 A 몫은 50%→62.5%로 오름). 점유율 상승을 곧 '언급이 늘었다'로 읽으면 오독입니다. ② 언급량 추이(절대값)와 함께 봅니다. 선을 쌓지 않으므로 그림만으로 합이 100%임을 확인할 수는 없고, 정확한 값은 툴팁으로 확인하세요.
결과를 종합해 읽는 원칙
같은 기간·같은 채널로 맞춘다
비교의 공정함은 조건 일치에서 나옵니다. 한 키워드만 유리한 기간이나 채널이 섞이면 점유율·추이 격차가 조건 탓인지 실제 화제 탓인지 구분되지 않습니다.
절대 언급량과 점유율을 함께 읽는다
규모가 큰 브랜드는 총량에서 늘 앞섭니다. '누가 화제 상승 중인가'는 점유율 추이의 기울기로, '얼마나 큰가'는 절대 언급량으로 나눠 판단합니다.
피크 일자의 어긋남에 주목한다
두 키워드의 피크가 다른 날이면 서로 다른 사건으로 화제가 된 것입니다. 피크 원문으로 내려가 각자의 원인을 확인해야 비교가 해석으로 이어집니다.
이건 조심하세요
비교 화면은 두 키워드를 나란히 놓는 것이 목적이라, 단일 언급량 분석의 요일 히트맵·변곡점 검출 같은 깊은 딥다이브는 담지 않습니다. 한 키워드의 원인을 파고들려면 그 키워드만 단일 언급량 분석으로 다시 보는 편이 더 자세합니다. 또한 점유율은 상대값이라 두 키워드 모두 조용해져도 한쪽 몫은 오를 수 있으니, 항상 절대 언급량과 짝지어 읽어야 오독을 피합니다.